
Z tego artykułu dowiesz się:
- czym różnią się roboty AI trenujące, wyszukujące i uruchamiane przez użytkownika
- które roboty AI odwiedzają dziś polskie strony i jak je rozpoznać
- co naprawdę blokujesz, wpisując GPTBot czy Google-Extended do pliku robots.txt
- jak wydawcy na świecie ustawiają robots.txt i co z tego wynika dla firm
- jak podjąć decyzję dla sklepu, firmy usługowej i wydawcy, z gotowymi wpisami do pliku
Coraz więcej właścicieli stron zadaje to samo pytanie: czy blokować roboty AI w robots.txt, czy raczej wpuścić je na stronę. Odpowiedź „to zależy” jest prawdziwa, ale bezużyteczna, więc w tym artykule pokazujemy, od czego dokładnie to zależy i jak wygląda praktyka.
Punkt wyjścia jest prosty: nie wszystkie roboty AI robią to samo. Jedne pobierają treści do trenowania modeli, inne szukają odpowiedzi na bieżące pytania użytkowników i podają źródła, a jeszcze inne wchodzą na stronę dopiero wtedy, gdy ktoś wklei link w czacie. Blokowanie wszystkich jednym wpisem to najczęstszy błąd, jaki widzimy w plikach robots.txt.
Spis treści
- Trzy rodzaje robotów AI
- Jak wydawcy na świecie ustawiają robots.txt
- Co zyskujesz, a co tracisz, blokując roboty AI
- Jak to ustawić: gotowe wpisy do robots.txt
- Czego robots.txt nie załatwi
- Co z tego wynika dla trzech typów firm
- Jak sprawdzić, które roboty odwiedzają Twoją stronę
- Roboty AI w robots.txt – podsumowanie
- Najczęściej zadawane pytania
Trzy rodzaje robotów AI
Zanim cokolwiek wpiszesz do pliku, warto zrozumieć podział, który wprowadzili sami dostawcy modeli.
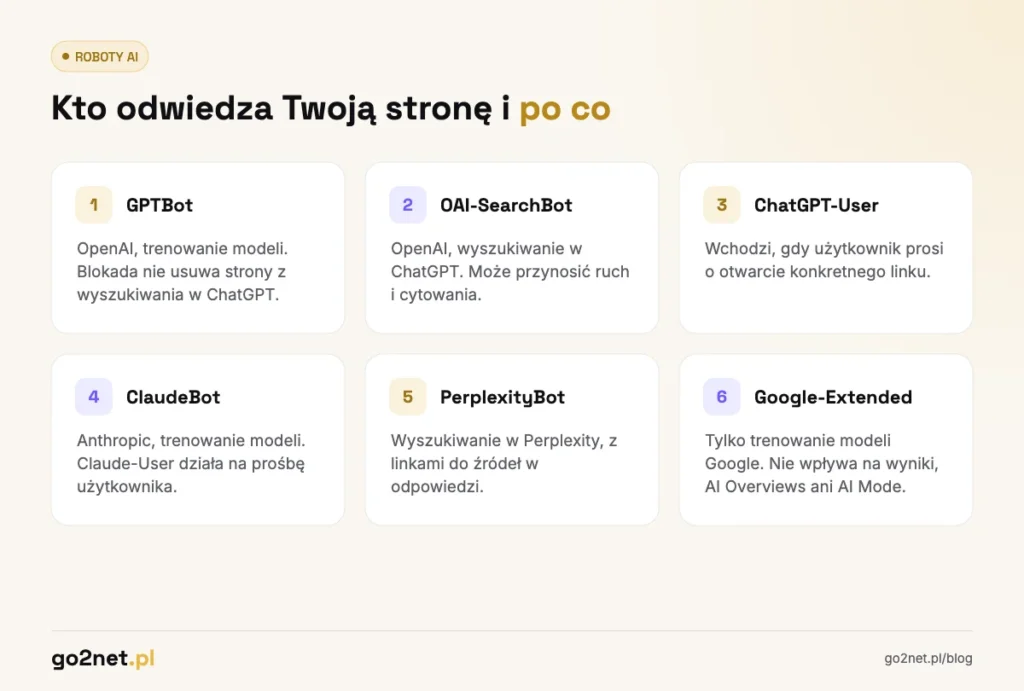
- Roboty trenujące pobierają treści, które mogą posłużyć do uczenia modeli. Należą do nich m.in. GPTBot (OpenAI), ClaudeBot (Anthropic) i Applebot-Extended (Apple). Ruch, który przynoszą, nie wraca do strony w postaci odwiedzin.
- Roboty wyszukujące zasilają funkcje wyszukiwania w asystentach i pokazują linki do źródeł. To m.in. OAI-SearchBot (wyszukiwanie w ChatGPT) i PerplexityBot. One mogą przynosić realny ruch.
- Roboty uruchamiane przez użytkownika wchodzą na stronę, gdy ktoś poprosi asystenta o otwarcie konkretnego adresu. To m.in. ChatGPT-User i Claude-User. Zablokowanie ich sprawia, że użytkownik nie zobaczy treści, o którą sam poprosił.
Osobną kategorią jest Google. Wyszukiwarka, AI Overviews i tryb AI Mode korzystają z tego samego Googlebota i tego samego indeksu. Token Google-Extended w pliku robots.txt nie dotyczy więc wyszukiwania, a jedynie wykorzystania treści do trenowania modeli Google.
blokując GPTBot, nie znikasz z ChatGPT, a blokując Googlebota, znikasz z całego Google
Jak wydawcy na świecie ustawiają robots.txt
Dane z sierpnia 2026 roku, oparte na analizie plików robots.txt w sieci Cloudflare, pokazują wyraźny wzorzec. Roboty trenujące są blokowane, a wyszukujące wpuszczane, często przez te same serwisy i wobec tych samych firm:
- GPTBot: około 2,3 razy częściej blokowany niż dopuszczany,
- ClaudeBot: około 2,4 razy częściej blokowany niż dopuszczany,
- Google-Extended: około 2,1 razy częściej blokowany niż dopuszczany,
- OAI-SearchBot: częściej dopuszczany niż blokowany.
Innymi słowy, wydawcy nie blokują „AI”. Blokują trenowanie i wpuszczają odpowiadanie, bo to drugie może przynieść odwiedziny. Warto przy tym pamiętać o proporcjach ruchu: zdecydowana większość wizyt robotów AI to pobieranie treści do trenowania, a nie obsługa konkretnych zapytań użytkowników.
Druga ważna obserwacja dotyczy egzekwowania. Plik robots.txt to prośba, a nie zabezpieczenie. Część firm dokłada więc blokady po stronie serwera lub usług typu Cloudflare, które odrzucają ruch robotów AI kodem 403. Jeśli zależy Ci na realnym ograniczeniu dostępu, sam wpis w robots.txt nie wystarczy.
Co zyskujesz, a co tracisz, blokując roboty AI
Decyzja wygląda inaczej dla każdego modelu biznesowego. Poniżej argumenty, które w naszej praktyce przeważają najczęściej.
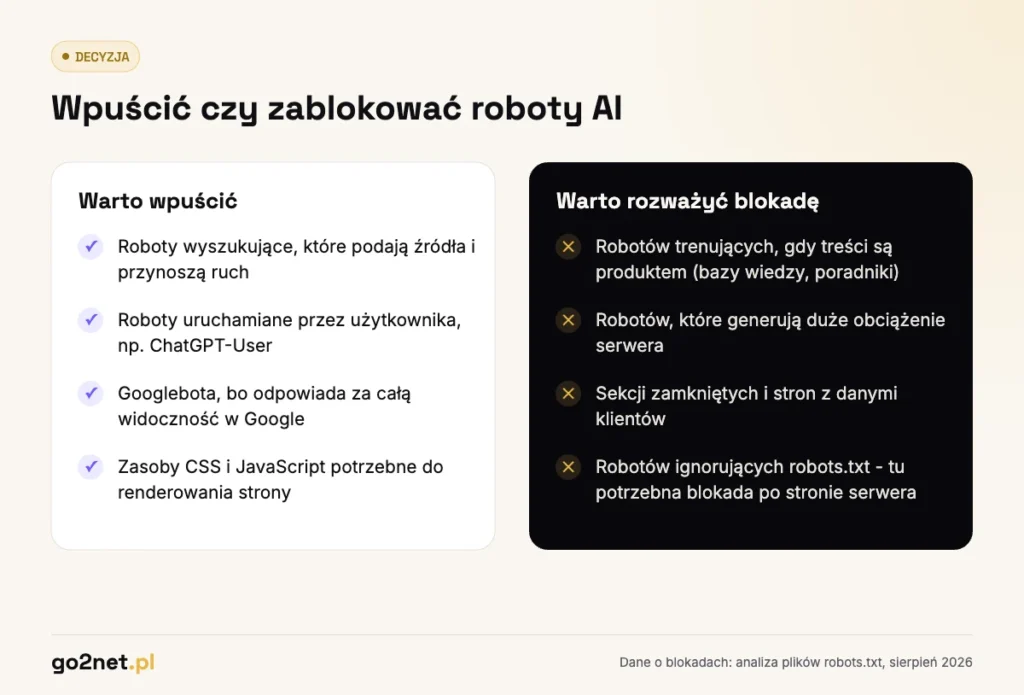
Argumenty za wpuszczeniem robotów wyszukujących
- Asystenci AI podają źródła, więc strona może dostać ruch; w Google Analytics 4 widać go jako odesłania z domen chatgpt.com, perplexity.ai czy gemini.google.com.
- Marka zyskuje obecność w odpowiedziach, nawet gdy użytkownik nie kliknie w link. Przy usługach lokalnych i B2B to często początek procesu zakupowego.
- Brak firmy w odpowiedziach AI oznacza, że asystent poleci konkurencję, korzystając z jej treści.
Argumenty za blokowaniem robotów trenujących
- Treści premium, poradniki i bazy wiedzy, które stanowią przewagę konkurencyjną, trafiają do modelu bez żadnego wynagrodzenia.
- Wydawcy, których model opiera się na reklamach i subskrypcjach, tracą podwójnie: oddają treść i odbierają sobie odwiedziny.
- Blokada robota trenującego zwykle nie wpływa na widoczność w wyszukiwarce ani w funkcjach wyszukiwania asystentów.
Jak to ustawić: gotowe wpisy do robots.txt
Poniższe przykłady wpisuje się do pliku robots.txt w katalogu głównym domeny (adres domena.pl/robots.txt). W WordPressie plik można edytować m.in. w Rank Math, w sekcji ustawień ogólnych.
Wariant 1: wpuszczam wyszukiwanie, blokuję trenowanie
Najczęstszy wybór firm, którym zależy na widoczności, ale nie chcą oddawać treści do trenowania modeli:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ChatGPT-User
Allow: /
Wariant 2: wpuszczam wszystko
Sensowny dla firm, dla których każda wzmianka to potencjalny klient, a treści na stronie nie są produktem same w sobie. W praktyce nie wymaga żadnych wpisów, bo domyślnie roboty mają dostęp.
Wariant 3: blokuję wszystko poza Google
Wybór wydawców i serwisów, które żyją z ruchu i reklam. Trzeba wtedy pamiętać, że blokada dotyczy także funkcji wyszukiwania w asystentach, więc strona przestaje być źródłem cytowań.
Niezależnie od wariantu, dwóch rzeczy nie należy blokować: Googlebota (bo znika cała widoczność w Google) oraz zasobów CSS i JavaScript potrzebnych do renderowania strony. Więcej o tym, jak roboty czytają stronę, piszemy w artykule o crawl-owaniu i renderowaniu w SEO.
Czego robots.txt nie załatwi
Trzy ograniczenia, o których warto wiedzieć, zanim uznasz temat za zamknięty.
Po pierwsze, robots.txt nie usuwa treści, które zostały już pobrane. Blokada działa na przyszłość.
Po drugie, nie wszystkie roboty respektują plik. Część mniejszych dostawców zwyczajnie go ignoruje, a wykrycie tego wymaga analizy logów serwera.
Po trzecie, w przypadku Google to nie robots.txt decyduje o obecności w funkcjach AI. Od sierpnia 2026 roku służy do tego osobne ustawienie „Search generative AI” w Google Search Console, a efekty widać w nowym raporcie wyświetleń. Opisujemy je w artykule o raporcie AI w Google Search Console. Warto też pamiętać, że dyrektywy nosnippet i max-snippet ograniczają fragmenty pokazywane przez Google, w tym w odpowiedziach AI. Zasady działania robotów Google opisuje oficjalna dokumentacja Google (w języku angielskim).
Co z tego wynika dla trzech typów firm
Ta sama konfiguracja nie pasuje do każdego biznesu. W praktyce rekomendacje układają się w trzy scenariusze.
Firma usługowa i lokalna. Treści na stronie nie są tu produktem, tylko sposobem na pozyskanie klienta. Każda wzmianka w odpowiedzi asystenta to potencjalne zapytanie ofertowe, dlatego blokowanie czegokolwiek poza robotami trenującymi zwykle nie ma sensu. Jeśli firma ma rozbudowaną bazę poradników, warto rozważyć blokadę robotów trenujących, ale roboty wyszukujące zostawić otwarte.
Sklep internetowy. Tu argument jest jeszcze mocniejszy, bo asystenci coraz częściej odpowiadają na pytania zakupowe i podają konkretne oferty. Blokada robotów wyszukujących oznacza oddanie pola konkurencji. Osobną kwestią są dane produktowe, które trafiają do Google inną drogą, przez Merchant Center.
Wydawca i serwis contentowy. Najtrudniejszy przypadek, bo treść jest jednocześnie produktem i jedynym źródłem ruchu. Tu blokada robotów trenujących jest regułą, a decyzja o robotach wyszukujących zależy od tego, czy odesłania z asystentów realnie przekładają się na odsłony. Warto to sprawdzić w danych, zanim zapadnie decyzja.
Niezależnie od scenariusza, konfigurację warto zapisać w dokumentacji projektu i wracać do niej co kwartał. Lista robotów zmienia się szybciej niż wytyczne dotyczące SEO.
Jak sprawdzić, które roboty odwiedzają Twoją stronę
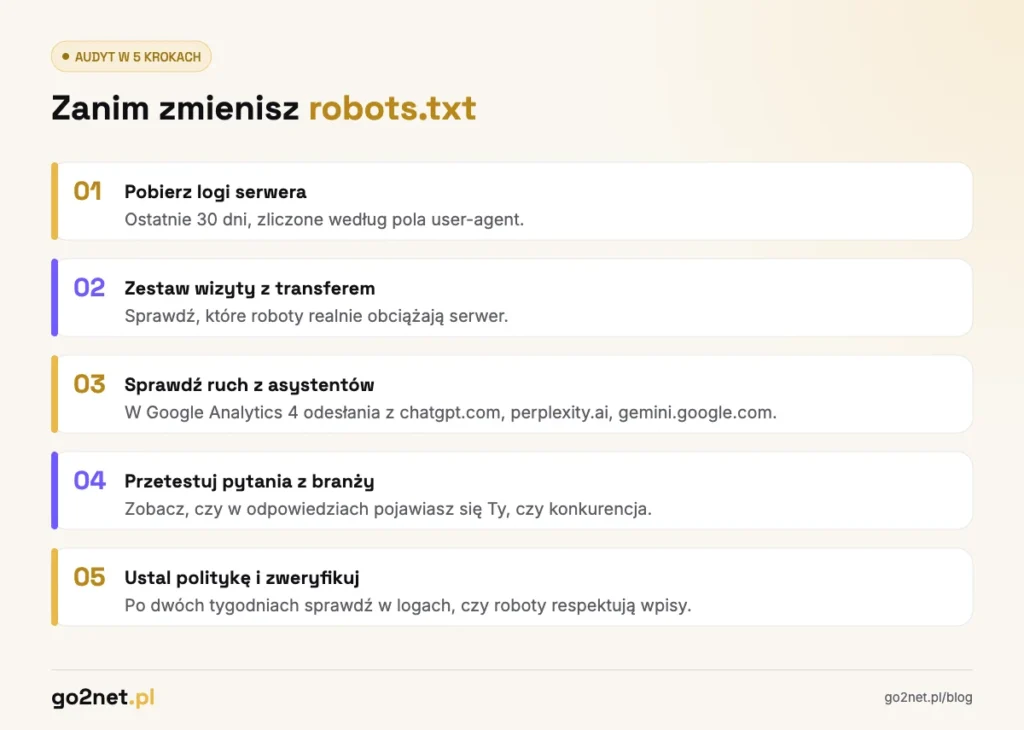
Zanim podejmiesz decyzję, warto zobaczyć dane z własnego serwera. Kolejność działań, którą stosujemy u klientów:
- Pobierz logi serwera z ostatnich 30 dni (u większości hostingów dostępne w panelu) i policz wizyty według pola user-agent.
- Zestaw liczbę wizyt każdego robota z transferem, jaki generuje. Przy dużych serwisach roboty AI potrafią realnie obciążać serwer.
- Sprawdź w Google Analytics 4 odesłania z domen asystentów AI, żeby zobaczyć, czy któryś z nich przynosi już ruch.
- Przetestuj kilka pytań z Twojej branży w ChatGPT i Perplexity i sprawdź, czy w odpowiedziach pojawiają się linki do Twojej strony lub do konkurencji.
- Dopiero wtedy ustal politykę i wpisz ją do robots.txt, a po dwóch tygodniach sprawdź w logach, czy roboty faktycznie ją respektują.
Roboty AI w robots.txt – podsumowanie
Decyzja o robotach AI nie jest wyborem między „AI tak” a „AI nie”. To wybór między oddawaniem treści do trenowania modeli a obecnością w odpowiedziach, które widzą klienci. Te dwie rzeczy można rozdzielić i większość wydawców na świecie właśnie to robi.
Dla typowej firmy usługowej i dla sklepu internetowego rekomendujemy dziś wariant pierwszy: wpuszczać roboty wyszukujące i te uruchamiane przez użytkownika, a blokować trenujące, jeśli treści na stronie są realną wartością. Dla Google decyzję podejmuje się osobno, w Search Console. A niezależnie od wszystkiego warto zacząć od logów, bo bez nich każda konfiguracja jest zgadywaniem. Jeśli chcesz, żeby ktoś przeanalizował to razem z techniczną stroną witryny, sprawdź nasze pozycjonowanie stron internetowych.
Najczęściej zadawane pytania
Czy blokada GPTBot usuwa moją stronę z ChatGPT?
Nie. GPTBot pobiera treści do trenowania modeli. Za wyszukiwanie w ChatGPT odpowiada OAI-SearchBot, a za otwieranie linków na prośbę użytkownika ChatGPT-User. To osobne roboty i osobne wpisy w robots.txt.
Czy Google-Extended wpływa na pozycje w Google?
Nie. Google-Extended dotyczy wyłącznie wykorzystania treści do trenowania modeli. Na indeksowanie, pozycje i obecność w AI Overviews oraz AI Mode nie ma wpływu.
Czy potrzebuję pliku llms.txt?
Według dokumentacji Google nie jest potrzebny do pojawienia się w funkcjach AI w wyszukiwarce. Część dostawców i wtyczek go promuje, ale żaden z dużych dostawców nie ogłosił, że traktuje go jako wymagany.
Czy roboty AI obciążają serwer?
Przy większych serwisach tak. Jeśli logi pokazują tysiące wizyt dziennie, warto rozważyć ograniczenie tempa pobierania po stronie serwera lub usługi CDN, a nie tylko wpis w robots.txt.
Jak sprawdzić, czy robot respektuje robots.txt?
Po wprowadzeniu zmiany należy sprawdzić logi serwera po kilkunastu dniach. Jeśli dany user-agent nadal pobiera strony mimo zakazu, jedynym skutecznym rozwiązaniem jest blokada po stronie serwera lub CDN.
Przeczytaj też
Sprawdźmy, jak to wygląda u Ciebie
Zostaw adres strony i e-mail. W ciągu 24 godzin roboczych odzywamy się z konkretem: na jakie frazy realnie możesz walczyć, co dziś blokuje Twoją widoczność i od czego zaczęlibyśmy pracę.
Zamów bezpłatną analizęBez zobowiązań. Bez prezentacji sprzedażowej. Odpowiada osoba, która prowadzi projekty.